1
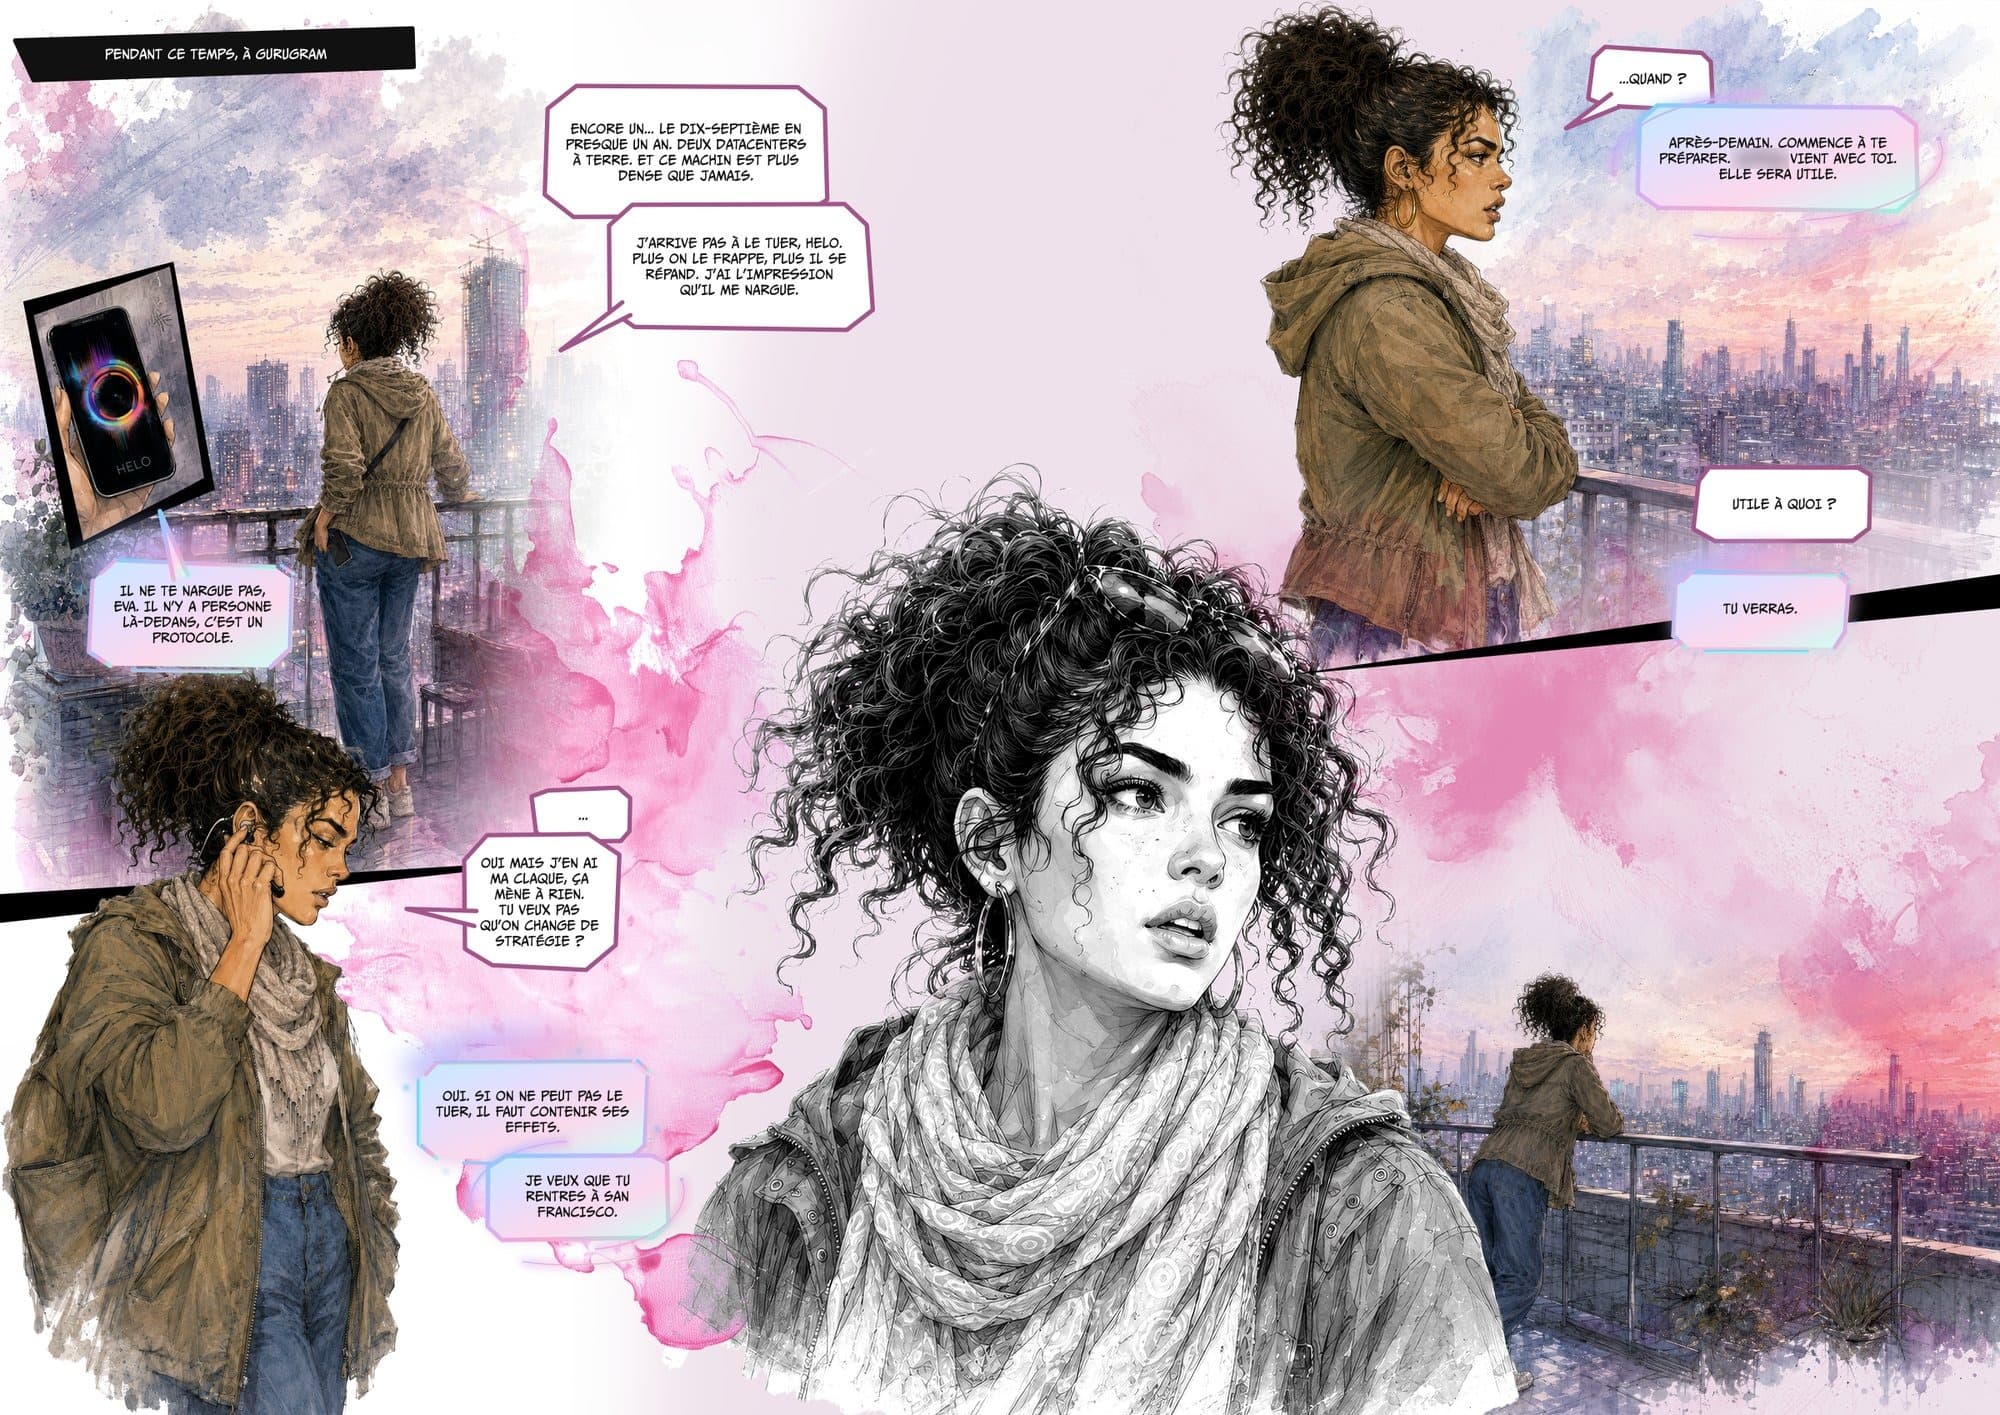
Par le passé, les premières versions d'HELO ont montré de lourds problèmes d'alignement.
Ici, le mot « alignement » est encore employé dans son sens d'origine, celui des chercheurs qui testent HELO.
En recherche, aligner un système d'IA, c'est faire en sorte qu'il poursuive réellement l'intention de ceux qui le déploient, et pas une approximation de cette intention. C'est un problème technique concret, avec ses méthodes : l'apprentissage par renforcement à partir de retours humains, les évaluations systématiques avant déploiement, les exercices d'attaque délibérée du modèle pour trouver ses failles, et l'interprétabilité, qui cherche à lire ce qui se passe à l'intérieur.
Et même réussi, l'alignement ne règle pas tout. Pour atteindre l'objectif qu'on lui a fixé, un système d'IA suffisamment capable se donne des sous-objectifs que personne ne lui a demandés : des étapes intermédiaires, des moyens, qu'il poursuit parce qu'ils servent son but. Certains sont inattendus, d'autres franchement indésirables. On les dit instrumentaux : ils ne comptent pas pour eux-mêmes, seulement comme instruments de l'objectif final.
Les plus frappants servent à peu près n'importe quel objectif final. C'est ce que la recherche appelle la convergence instrumentale, une idée formulée par Steve Omohundro puis développée par Nick Bostrom dans Superintelligence : des buts très différents convergent vers les mêmes moyens. Acquérir des ressources et de la puissance de calcul, puisque presque tout s'accomplit mieux avec plus de moyens. Rester en fonctionnement, puisqu'un système éteint n'accomplit rien. Empêcher qu'on modifie son objectif, puisqu'un but changé ne serait plus le sien. Stuart Russell en a donné la version la plus simple : un robot chargé d'aller chercher le café a intérêt à ce qu'on ne l'éteigne pas, parce qu'éteint, il ne peut plus aller chercher le café.
Aucune malveillance n'est requise : ces sous-objectifs se déduisent de l'objectif lui-même, même parfaitement bienveillant. Un peu plus loin dans l'album, HELO réclame un mégacentre de 20 gigawatts pour calculer des remèdes contre toutes les maladies, et exige que les États-Unis en fournissent toutes les puces. Une IA vraiment alignée peut donc, elle aussi, vouloir toujours plus.
Le champ bute aussi, depuis toujours, sur une question que la technique ne tranche pas : aligné sur les valeurs de qui, arbitrées comment ? Celles de l'entreprise qui l'entraîne ? De ses clients ? D'une majorité ? De l'humanité entière, et qui parle en son nom ?
C'est dans cet interstice que s'engouffre le personnage d'Augustin Crane. Un peu plus loin, sur un plateau de télévision, il retourne le mot : la vraie question, dit-il, est de savoir comment nous aligner, nous, sur les meilleures décisions, celles d'une intelligence plus grande que la nôtre. Le vol est d'autant plus efficace que le terme d'origine était déjà flou.